[Actualizado a 14 de octubre de 2026]
T1. Captura, limpieza y normalización de datos🔗
1. El Flujo de Trabajo en el Análisis de Datos (Data Analysis Workflow)🔗
1.1. Por qué necesitamos un flujo estructurado🔗
El análisis de datos en la industria actual va mucho más allá de ejecutar consultas esporádicas o aplicar scripts aislados. Al abordar un problema real, nos enfrentamos a volúmenes masivos de información heterogénea y frecuentemente incompleta o errónea. Adoptar un flujo de trabajo estructurado (Data Analysis Workflow) aporta tres beneficios clave:
- Sistemática y Reducción de Errores: Define una secuencia clara de pasos que minimiza la omisión de validaciones críticas (como la detección de nulos o el filtrado de valores atípicos).
- Repetibilidad (Reproducibility): Permite que cualquier miembro del equipo (o un pipeline automatizado) ejecute las mismas transformaciones sobre datos futuros y obtenga resultados consistentes.
- Escalabilidad: Facilita la transición desde prototipos analíticos locales hacia entornos de producción en la nube o arquitecturas Big Data.
1.2. Etapas del ciclo de vida del dato🔗
Aunque existen metodologías estándar como CRISP-DM, en el contexto del desarrollo de software con Python se adopta una aproximación iterativa e interactiva basada en 5 fases principales:
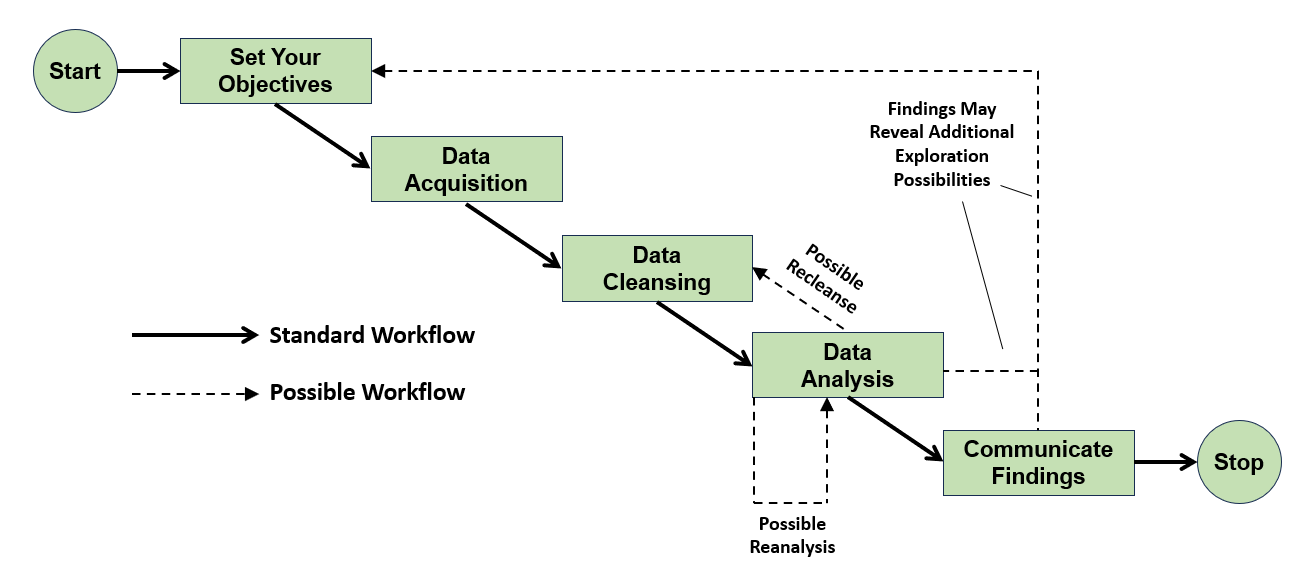
| Fase | Descripción | Salida/Entregable |
|---|---|---|
| 1. Objetivos | Definición de las preguntas clave y métricas de éxito. | Documento de requisitos / KIPs |
| 2. Adquisición | Lectura e ingesta de datos (CSV, JSON, SQL, APIs). | Raw Dataset (inmutable) |
| 3. Limpieza | Corrección de tipos, imprecisos, atípicos y nulos. | Cleaned Dataset / Data Lake |
| 4. Análisis | Exploración de patrones, agrupaciones y correlaciones. | Gráficos, métricas y modelos |
| 5. Comunicación | Informes visuales o despliegue de dashboards/APIs. | Reporte final / API REST |
Note
La naturaleza del proceso es iterativa (líneas discontinuas del diagrama). Durante la fase de análisis es habitual descubrir anomalías que obligan a regresar a la fase de limpieza o a reformular preguntas en la fase de objetivos.
1.3. Definición de Objetivos: Preguntas de negocio vs. Exploración abierta🔗
Antes de escribir una sola línea de código en Python, es imprescindible definir el alcance. La falta de objetivos claros conduce a análisis dispersos (parálisis por análisis).
- Exploración Abierta: "Vamos a ver qué datos hay en el archivo
james_bond_data.csv." (Útil para un primer contacto, pero ineficiente para tomar decisiones). - Preguntas de Negocio Concretas:
- ¿Existe correlación directa entre el presupuesto (Budget) y la recaudación global (World Gross)?
- ¿El cambio de actor protagonista influye en las puntuaciones medias de la audiencia (IMDb vs Rotten Tomatoes)?
- ¿Se pueden corregir los incoherencias tipográficas en las fechas de estreno antes de procesar la rentabilidad histórica?
1.4. Entorno de trabajo práctico: Jupyter Notebooks vs Scripts .py🔗
Para el análisis exploratorio de datos, el estándar industrial es el entorno de cuadernos interactivos (Jupyter Notebooks / JupyterLab).
¿Por qué Jupyter para el análisis de datos?🔗
- REPL extendido: Permite ejecutar celdas de código de manera independiente sin recargar todo el dataset en memoria.
- Prototipado rápido: Inspección inmediata del estado de los
DataFramesde pandas mediante tablas formateadas en HTML. - Integración narrativa: Combina explicaciones en Markdown, ecuaciones LaTeX, código ejecutable y gráficos intercalados en un solo documento (
.ipynb).
Ejemplos Prácticos de Código🔗
Ejemplo 1.1: Configuración inicial e inspección de memoria🔗
Crearemos un cuaderno donde cargamos nuestro primer dataset de trabajo y optimizamos el uso de tipos de datos nativos de pandas mediante .convert_dtypes().
import pandas as pd

# 1. Carga inicial del conjunto de datos crudo (Raw Data)
file_path = "james_bond_data.csv"
df_raw = pd.read_csv(file_path)

# 2. Inspección rápida del tipo de datos inferido automáticamente
print("--- Tipos de datos iniciales ---")
print(df_raw.dtypes)

# 3. Optimización automática de tipos de datos (Pandas 1.0+)
# Convierte int64 a Int64 (soporta NAs), object a string, etc.
df_clean = df_raw.convert_dtypes()

print("\n--- Tipos de datos optimizados ---")
print(df_clean.dtypes)

# 4. Comprobación del uso de memoria en RAM
print(f"\nUso de memoria raw: {df_raw.memory_usage(deep=True).sum() / 1024:.2f} KB")
print(f"Uso de memoria optimizado: {df_clean.memory_usage(deep=True).sum() / 1024:.2f} KB")
Ejemplo 1.2: Auditoría básica de un Dataset al iniciar el flujo🔗
Antes de limpiar datos, debemos evaluar el "estado de salud" del archivo mediante un resumen estructurado.
def auditar_dataset(df: pd.DataFrame) -> None:
    """Imprime una auditoría rápida del estado de salud del DataFrame."""
    print("====== AUDITORÍA RÁPIDA DE DATASET ======")
    print(f"Número de Filas: {df.shape[0]}")
    print(f"Número de Columnas: {df.shape[1]}")
    print("\n--- Valores Ausentes por Columna ---")

    missing = df.isnull().sum()
    missing_pct = (missing / len(df)) * 100

    df_missing = pd.DataFrame({'Absolutos': missing, 'Porcentaje (%)': missing_pct.round(2)})
    print(df_missing[df_missing['Absolutos'] > 0])

    print("\n--- Conteo de Filas Duplicadas ---")
    print(f"Total duplicados: {df.duplicated().sum()}")

# Ejemplo de uso con nuestro dataframe
auditar_dataset(df_clean)
Ejercicios Propuestos🔗
Ejercicio 1.1 (Teórico-Práctico): Formulación de Preguntas de Negocio🔗
Consigna: Dado un dataset hipotético sobre aparcamientos públicos de la ciudad que contiene las columnas [id_parking, ubicacion, plazas_totales, plazas_ocupadas, tarifa_hora, fecha_hora, estado_sensor]:
- Identifica dos preguntas concretas de negocio que puedan responderse con este conjunto de datos.
- Señala qué fase del flujo de trabajo se vería afectada si descubres que la columna
tarifa_horacontiene texto como"1,50 €"en lugar de un número flotante1.50.
Solución Sugerida
- Preguntas de negocio:
- ¿Cuáles son las horas pico de ocupación media por zona/ubicación?
- ¿Existe relación entre la tarifa por hora y el porcentaje de ocupación media?
- Fase afectada: Afectaría a la Fase 3 (Limpieza de datos). Deberá realizarse un formateo de cadenas de texto (extraer el símbolo
€, reemplazar comas por puntos y castear el tipo afloat64/Float64) antes de poder realizar el análisis estadístico o numérico en la Fase 4.
Ejercicio 1.2 (Programación): Primer script de ingesta y diagnóstico🔗
Consigna: Escribe una función en Python cargar_y_diagnosticar(ruta_csv: str) que:
- Lea un archivo CSV utilizando
pandas. - Muestre por pantalla los nombres de las columnas que contienen valores nulos y la cantidad de nulos en cada una.
- Devuelva
Truesi el dataset no tiene duplicados, oFalseen caso de que existan registros duplicados.
Solución Sugerida
import pandas as pd

def cargar_y_diagnosticar(ruta_csv: str) -> bool:
     try:
        # 1. Carga del CSV
        df = pd.read_csv(ruta_csv)

        # 2. Diagnóstico de nulos
        nulos = df.isnull().sum()
        columnas_con_nulos = nulos[nulos > 0]

        print("--- Columnas con valores nulos ---")
        if columnas_con_nulos.empty:
            print("No hay valores nulos en el dataset.")
        else:
            for col, cant in columnas_con_nulos.items():
                print(f"Columna '{col}': {cant} nulos")

        # 3. Verificación de duplicados
        total_duplicados = df.duplicated().sum()
        print(f"\nDuplicados encontrados: {total_duplicados}")

        return total_duplicados == 0

    except FileNotFoundError:
        print(f"Error: El archivo en '{ruta_csv}' no existe.")
        return False
2. Adquisición e Ingesta de Datos (Data Acquisition)🔗
-
Fuentes de datos y formatos comunes:
- Archivos de texto plano y tabulares (CSV, TSV).
- Archivos estructurados y semiestructurados (JSON, YAML, XML).
- Documentos de texto / reporte (PDF, TXT).
- Ingesta mediante Python nativo (Estrategias de lectura, punteros, manejo de excepciones e I/O).
-
Ingesta optimizada con Pandas:
-
pd.read_csv(),pd.read_json(), etc. - Ajuste de tipos durante la carga con
.convert_dtypes(). - Control de calidad inicial: Preservar los datos originales (raw data) y versionar el dataset de trabajo.
3. Limpieza de Datos (Data Cleansing & Preprocessing)🔗
-
Estandarización de estructuras:
- Normalización y renombrado de columnas.
- Eliminación de espacios y caracteres especiales en encabezados.
-
Gestión de valores faltantes (Missing Data):
-
Tipos de ausentes:
np.nanvspd.NA. - Estrategias: Detección, imputación o eliminación controlada.
-
Corrección de tipos de datos e inconsistencias:
-
Conversión de tipos (Casteos de texto a numérico/fecha).
- Tratamiento de datos financieros, monedas y unidades de medida.
- Corrección de errores tipográficos y categorización inconsistente.
-
Detección de atípicos (Outliers) y duplicados:
-
Reglas de validación de dominio.
- Identificación y eliminación de registros duplicados (
.drop_duplicates()).
4. Normalización y Transformación de Datos🔗
- Escalado y Normalización (Min-Max Scaling, Standard Scoring / Z-score).
- Codificación de variables categóricas (One-Hot Encoding, Label Encoding).
- Transformación de fechas y series temporales básicas.
5. Almacenamiento y Persistencia de Datos Limpios🔗
- Exportación de datasets transformados (
to_csv(),to_parquet(),to_json()). - Buenas prácticas en el control del historial de procesado.
6. Caso Práctico Integrado (Dataset Unificado)🔗
- Planteamiento del problema con un dataset real/manipulado.
- Ingesta + Limpieza paso a paso + Normalización + Exportación.